近期关注到群晖 DSM 系统相关的安全漏洞及勒索软件攻击事件。考虑到 NAS 中保存着重要的虚拟机备份数据,我决定对现有群晖设备开展一次安全审计,重点检查 DSM 版本、已知漏洞、服务暴露情况,以及 Active Backup for Business(ABB)备份任务的运行状态。
在检查过程中,群晖系统曾出现异常,我随后进行了 DSM 更新。维护前后,VMware ESXi 上一台运行 Ubuntu 的 MES 生产虚拟机出现故障:系统提示虚拟磁盘锁丢失(VMDK Lock Lost),随后虚拟机变成不可访问(Inaccessible)状态。
原本只是一次针对备份设备的安全检查,最后却牵涉到生产虚拟化环境。经过排查,我发现问题与此前使用群晖 ABB 即时恢复(Instant Restore)所留下的 NFS 存储依赖密切相关。
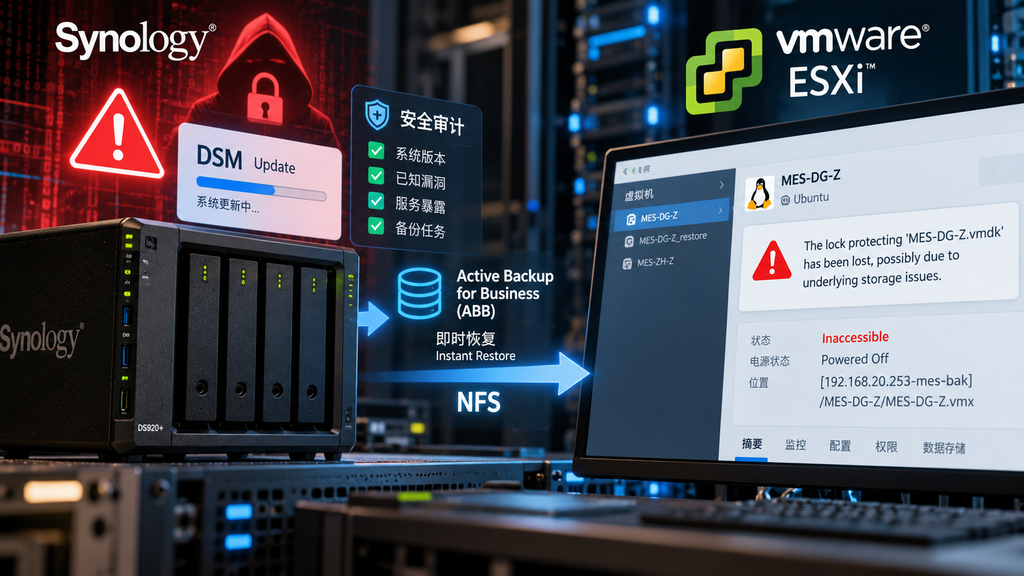
本文记录实际排查过程和经验。需要提前说明:NFS 存储访问异常已得到证据支持;DSM 更新是否直接触发此次中断,仍需结合双方日志时间线进一步确认。
一、故障现象:VMDK 锁突然丢失
故障发生时,ESXi 提示:
msg.hbacommon.locklost:
The lock protecting 'MES-DG-Z.vmdk' has been lost,
possibly due to underlying storage issues.
大意是:保护该虚拟磁盘的锁已经丢失,可能与底层存储异常有关。随后,虚拟机无法正常操作,在 ESXi 管理界面中显示为不可访问状态。
由于 MES 是生产业务系统,我最初怀疑虚拟磁盘或本地 RAID 存在问题。但同一台 ESXi 上的其他虚拟机依然正常运行,因此需要先查明:故障虚拟机实际运行在哪个数据存储上?
二、检查虚拟机注册状态
通过 SSH 登录 ESXi,执行:
vim-cmd vmsvc/getallvms返回结果的关键部分:
Skipping invalid VM '4'

Vmid  Name               File
2     MES-ZH-Z           [DATA] MES-ZH-Z/MES-ZH-Z.vmx
8     MES-DG-Z_restore   [DATA] MES-DG-Z_restore/MES-DG-Z_restore.vmx
其中的 Skipping invalid VM '4' 表示 VMID 4 对应的虚拟机注册信息异常。继续查询:
vim-cmd vmsvc/get.summary 4
vim-cmd vmsvc/get.config 4
关键信息如下:
name = "MES-DG-Z"
connectionState = "inaccessible"
powerState = "poweredOff"
vmPathName = "[] /vmfs/volumes/1723cc26-19ebff34/MES-DG-Z/MES-DG-Z.vmx"

Configuration is invalid
至此确认,VMID 4 就是原来的 MES-DG-Z,ESXi 已经无法正常读取其配置。需要注意,清单中还存在一台位于本地 DATA 数据存储上的 MES-DG-Z_restore;仅凭名称不能判断它是否为可直接切换的恢复实例,必须先核实其虚拟磁盘和业务角色,避免重复实例同时写入生产数据。
三、检查虚拟机目录,发现 I/O 错误
根据 vmPathName 给出的路径,尝试读取虚拟机目录:
ls -lah /vmfs/volumes/1723cc26-19ebff34/MES-DG-Z/结果:
Input/output error继续检查数据存储根目录:
ls -lah /vmfs/volumes/1723cc26-19ebff34/仍然返回:
Input/output error如果只是 VMX 文件内容损坏,通常不足以解释整个存储目录都无法读取。因此,这时应当把排查重点从单个 VMX、VMDK 文件转向数据存储本身。
四、真正的转折点:原虚拟机位于 NFS 数据存储
执行:
esxcli storage filesystem list输出中主要有三个数据存储:
| 数据存储 | 类型 | 容量(约) | 排查时的状态 |
|---|---|---|---|
| DATA | VMFS-6 | 24 TB | 可正常访问 |
| datastore1 | VMFS-6 | 341 GB | 可正常访问 |
| 192.168.20.253-mes-bak | NFS | 显示为 0 B | 挂载记录存在,但读取失败 |
故障虚拟机所在 UUID 1723cc26-19ebff34 对应的并不是本地 VMFS,而是群晖 NAS 提供的 NFS 数据存储:
Mount Point: /vmfs/volumes/1723cc26-19ebff34
Volume Name: 192.168.20.253-mes-bak
Mounted: true
Type: NFS
Size: 0
Free: 0
这里的 Mounted: true 只表示 ESXi 仍保留挂载记录,不能证明实际文件访问正常。结合目录读取时的 I/O 错误,故障已经指向该 NFS 数据存储的访问问题。
本地 DATA 中的其他虚拟机仍然正常,也因此有了解释:它们并不依赖这个异常的 NFS 挂载。
五、回想起来:此前使用过 ABB 即时恢复
排查到这一步,我想起此前为了尽快恢复 MES 业务,使用过群晖 Active Backup for Business 的即时恢复功能,而不是直接做完整恢复。
1. ABB 即时恢复(Instant Restore)
即时恢复允许 ESXi 直接使用 NAS 上的恢复数据启动虚拟机,不必先把完整虚拟磁盘复制到生产数据存储,能够明显缩短恢复等待时间。
群晖 NAS(ABB 备份数据)
        │
        │ NFS
        ▼
    VMware ESXi
        │
        ▼
MES 生产虚拟机但是,虚拟机恢复运行,不代表磁盘已经迁回正式生产存储。在未完成迁移之前,NAS 的可用性、NFS 服务以及相关网络链路都可能直接影响生产业务。
2. ABB 完整恢复
完整恢复则是把虚拟机数据恢复到指定的数据存储,例如本地 DATA:
群晖 NAS(ABB 备份数据)
        │
        │ 完整恢复
        ▼
ESXi 正式生产数据存储(DATA)
        │
        ▼
   MES 生产虚拟机
只有确认 VMX、所有 VMDK 及必要的快照链均位于正式数据存储,并完成业务验证,才能认定虚拟机已摆脱原来的即时恢复 NFS 依赖。
这两种方式的核心区别,不是虚拟机能否开机,而是恢复后的虚拟机实际运行在哪里。
六、DSM 升级可能是故障触发因素,但尚未证实
本次故障发生前后,群晖设备出现过异常并进行了 DSM 更新,因此有必要调查升级、重启、NFS 服务状态变化与 ESXi 故障之间的关系。
一种可能的故障链是:
ABB 即时恢复的虚拟机运行在 NAS NFS 上
                │
                ▼
DSM 维护 / NAS 或 NFS 服务发生中断(待核实)
                │
                ▼
ESXi 无法正常访问 VMX / VMDK
                │
                ▼
磁盘锁丢失、配置读取失败
                │
                ▼
虚拟机显示 Inaccessible
但这只是待验证的解释。已经确认的是,ESXi 无法正常访问 ABB 即时恢复对应的 NFS 数据存储;尚不能把 DSM 更新认定为唯一根因。要确认触发事件,还需要对照 ESXi 内核日志、DSM 系统日志、ABB 任务日志及实际维护时间。
即使最终证明 NFS 中断另有原因,这次事件所揭示的生产存储依赖风险仍然成立。
七、遇到类似问题应该如何排查?
如果 ESXi 虚拟机出现 VMDK Lock Lost、Inaccessible 或 Configuration is invalid,不要立即删除锁文件、注销虚拟机或强制卸载数据存储。建议按以下顺序定位问题。
第一步:确认虚拟机注册状态和 VMX 路径
vim-cmd vmsvc/getallvms
vim-cmd vmsvc/get.summary 4
4 是本次案例的 VMID,其他环境需替换为对应编号。重点查看 vmPathName 和 connectionState。
第二步:检查数据存储类型及挂载状态
esxcli storage filesystem list
esxcli storage nfs list
esxcli storage nfs41 list
将 VMX 路径对应到真实的数据存储,判断是 VMFS、NFS 还是其他类型,不要只看虚拟机名称。
第三步:验证 NAS 的基础网络连通性
vmkping 192.168.20.253注意:vmkping 正常只能证明相关网络路径具备基础连通性,不等于 NFS 共享、权限和存储 I/O 都正常。如果 NAS 使用了专门的存储 VMkernel 接口,还应从对应接口和 TCP/IP 栈进行验证。
第四步:查看 ESXi 内核日志
grep -Ei 'NFS|APD|timeout|locklost|I/O error' /var/log/vmkernel.log | tail -100重点检查 NFS 连接丢失、APD、I/O 超时以及磁盘锁异常是否发生在同一个时间窗口。比较 DSM 日志前,先统一时间和时区。
第五步:检查群晖 DSM、NFS 与 ABB 状态
登录 DSM,检查系统事件、NFS 服务、网络及存储状态,确认 ABB 即时恢复任务是否仍在使用该 NFS 共享。若发现异常,先保护已有备份和磁盘状态,再制定恢复方案。
在存储依赖关系未查清之前,不要随意删除 ABB 恢复任务、清理 VMDK 锁文件或启动多个可能写入同一业务数据的虚拟机实例。
八、这次故障带来的几个教训
1. 即时恢复是应急阶段,不代表恢复工作已经结束
ABB 即时恢复非常实用,尤其适合大容量虚拟机的快速恢复。但业务重新启动后,还需要安排正式迁移、数据验证和备份验证,否则临时恢复环境可能长期承担生产负载。
2. 必须确认虚拟机真实的存储位置
这次初期排查时,我先考虑了本地 RAID 和 VMFS,直到核对 esxcli storage filesystem list,才发现原生产虚拟机其实位于群晖 NFS 上。今后需要优先核实 VMX、VMDK 和快照文件的实际路径。
3. 备份设备也可能成为生产系统的单点故障
如果生产虚拟机仍通过 NFS 从 ABB 即时恢复环境运行,那么 NAS 的维护、网络与存储可用性就不再只是备份系统的问题,而是直接关系到生产业务。
4. 恢复后必须完成验收
以后使用 ABB 恢复重要业务虚拟机,我会检查:
- 虚拟机能否正常启动,业务流程是否恢复。
- VMX、所有 VMDK 和相关快照链是否位于预期的生产数据存储。
- 操作系统文件系统、数据库与业务数据是否一致。
- 新备份任务和恢复点是否可用。
- 是否已经按照受支持的流程结束即时恢复并清理临时依赖。
尤其对于 MES、ERP、数据库等生产系统,恢复验收不能仅以“虚拟机开机成功”为标准。
九、写在最后
这次 MES 虚拟机故障,最初看到的是 VMDK 锁丢失,接着是 VMX 配置读取失败和虚拟机不可访问,最后才沿着实际存储路径定位到群晖 NFS 数据存储异常。
它提醒我:虚拟机恢复成功,并不代表虚拟机已经回到了原来的生产架构。 ABB 即时恢复可以在紧急情况下快速恢复业务,但应当有明确的迁移和退出计划,而不是让临时恢复存储在无人察觉的情况下长期承担生产业务。
以后我会把 恢复业务 → 验证数据 → 迁移正式存储 → 验证备份 作为完整恢复流程,而不是停留在虚拟机能够开机的阶段。
至于本次 DSM 更新与 NFS 故障之间的直接因果关系,还需要进一步比对日志才能下结论。把已经确认的事实和仍需验证的部分分开记录,也算是给以后的自己留下一份更可靠的排障参考。
备份的价值不仅在于能恢复,更在于恢复后能够回到可控、可维护的生产状态。